语音输入 × TWS 耳机 · 自用版本 · 持续迭代
声墨 · VoxInk
以声为墨,声音直接落笔成字
按住一个键说话。松开后落进光标的不是识别原文,而是可以直接发出去的书面文字。
- Windows10 / 11 · 已可用
- iOS即将推出 · 点此预约
- Android即将推出 · 点此预约
移动端会陆续推出;Windows 版为当前自用版本,尚未对外发布。


按下 · 说完 · 松开
一次输入
它替你把话写完整
不用先想好怎么说,也不用挑词。松开按键之后,落进光标位置的是可以直接发出去的书面文字——下面这段是真实流程的动画演示。
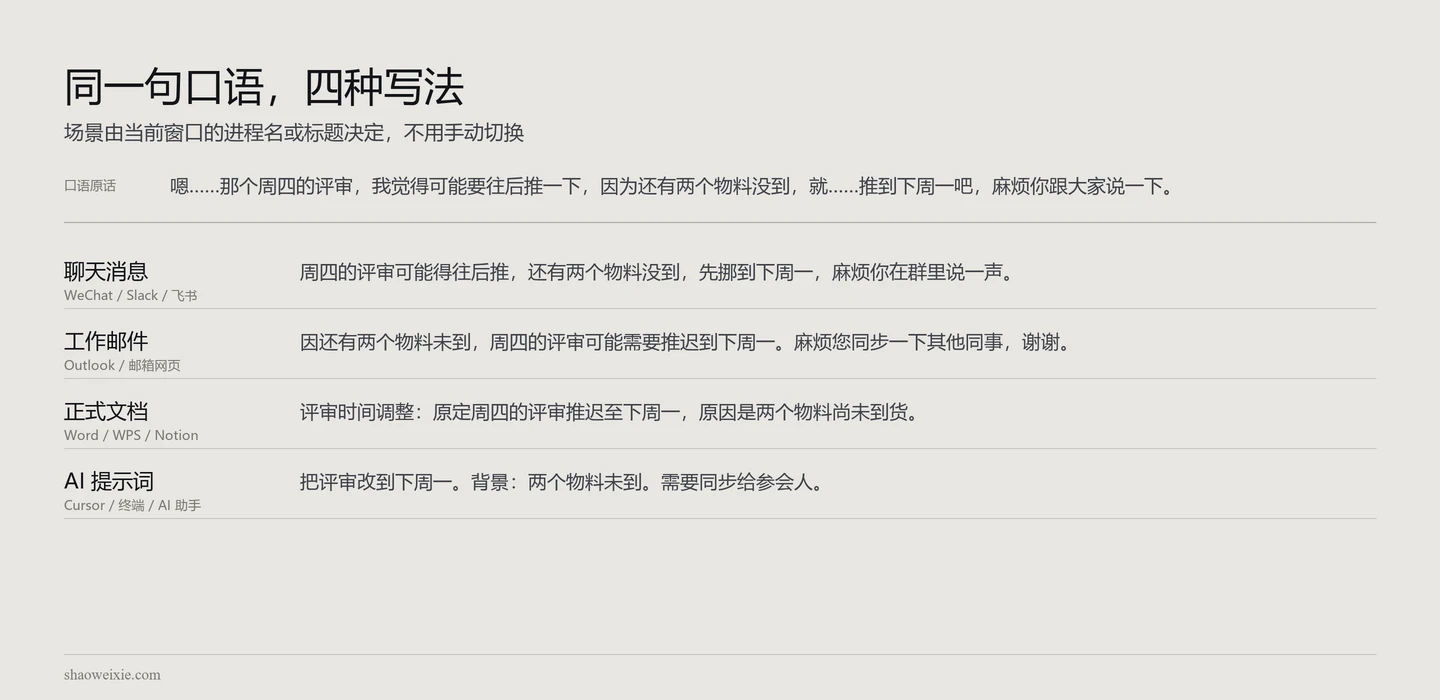
因还有两个物料未到,周四的评审可能需要推迟到下周一。麻烦您同步一下其他同事,谢谢。
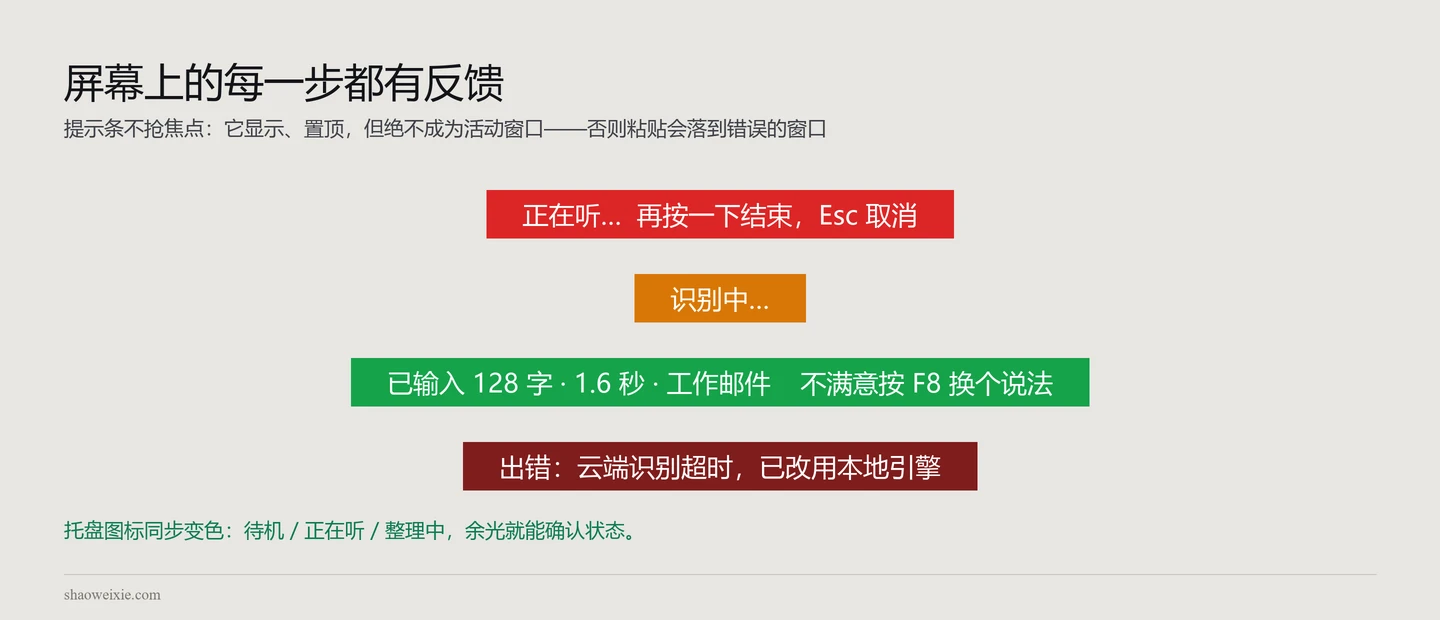
动画由页面本身播放(CSS 逐帧),不是录屏:文字逐字写入 → 提示条走完「正在听 → 识别中 → 已输入」→ 托盘图标同步变色。
识别能力
语言与方言
普通话、粤语、英语,混着说也行
识别引擎按多语种与方言设计,开口前不需要先选模式,一句话里中英夹杂也能识别。
- 普通话
- 粤语
- 英语
- 日语
- 吴语
- 闽语
- 客家话
- 赣语
- 湘语
- 晋语
- 中文方言
- 7 种:吴语、粤语、闽语、客家话、赣语、湘语、晋语
- 地域口音
- 26 种:河南、陕西、湖北、四川、重庆、云南、贵州、广东、广西、河北、天津、山东、安徽、南京、江苏、杭州、甘肃、宁夏等
- 外语
- 英语、日语;识别引擎支持语种自由切换与混合识别
- 中英混说
- 「这个 assert 要加 timeout」这类中英夹杂不用切换模式
- 输出语言
- 说中文可直接输出 English / 日本語 译文,专有名词保持原样
- 专有名词
- 热词表纠正同音错字:人名、公司名、产品型号以你的写法为准
能力来自识别引擎:本地为 Fun-ASR-Nano(中文含 7 方言与 26 口音、英文、日文),云端为实时识别引擎,两者可在托盘里切换。
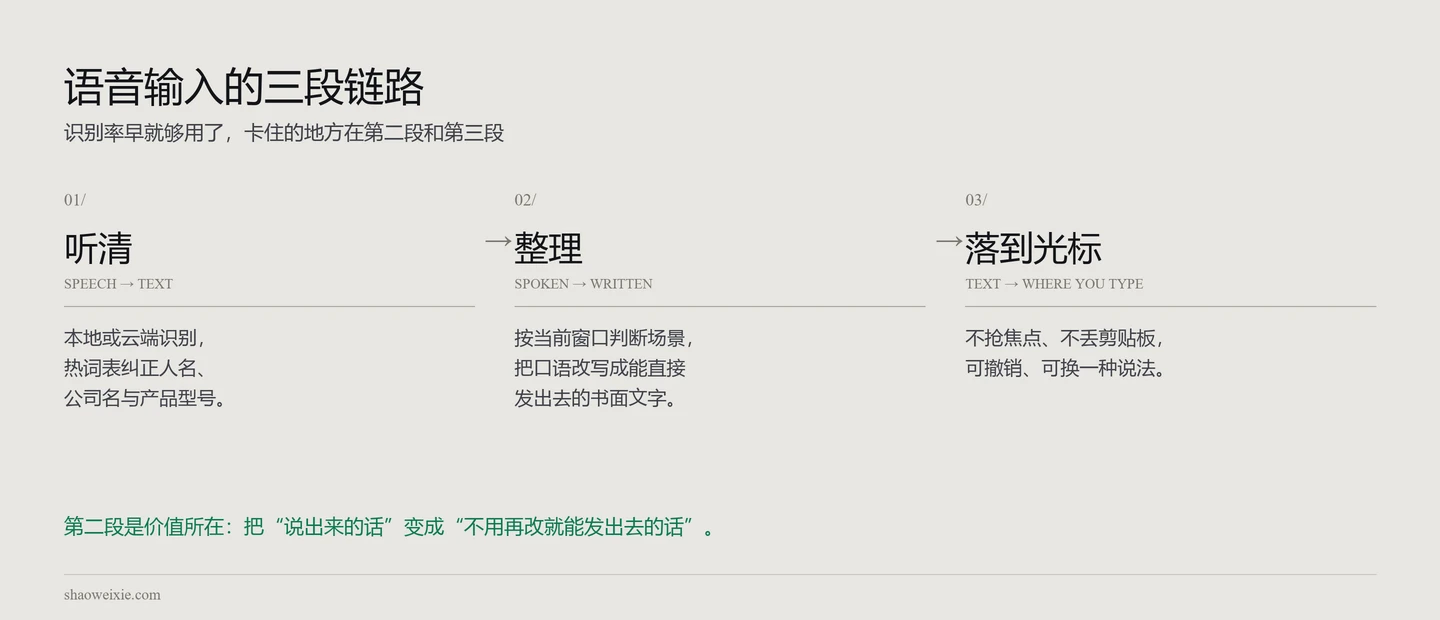
第一段
听清
边说边出字,专有名词不会认错
按下按键就建立连接,不用等你说完;云端不可用时自动切到本地模型,离线也能用。人名、公司名、产品型号写进一个纯文本文件——识别时作为偏置提示,整理时作为基准,改完保存立即生效。
第二段
整理
同一句口语,按场景写成四种文字
程序看当前窗口判断你在写什么——聊天、邮件、文档还是给 AI 的提示词。五条护栏写死在提示词里:不添加原文没有的事实与承诺,不把「可能」写成「确定」,说错改口只留最终说法。
第三段
落到光标
每一步有反馈,每一步能反悔
提示条显示、置顶,但绝不抢走你正在打字的窗口的焦点;粘贴前等你松开按键,用完把剪贴板还回去。整理得不合心意,按一下 F8 换一种说法,可以连续换。
托盘
控制台
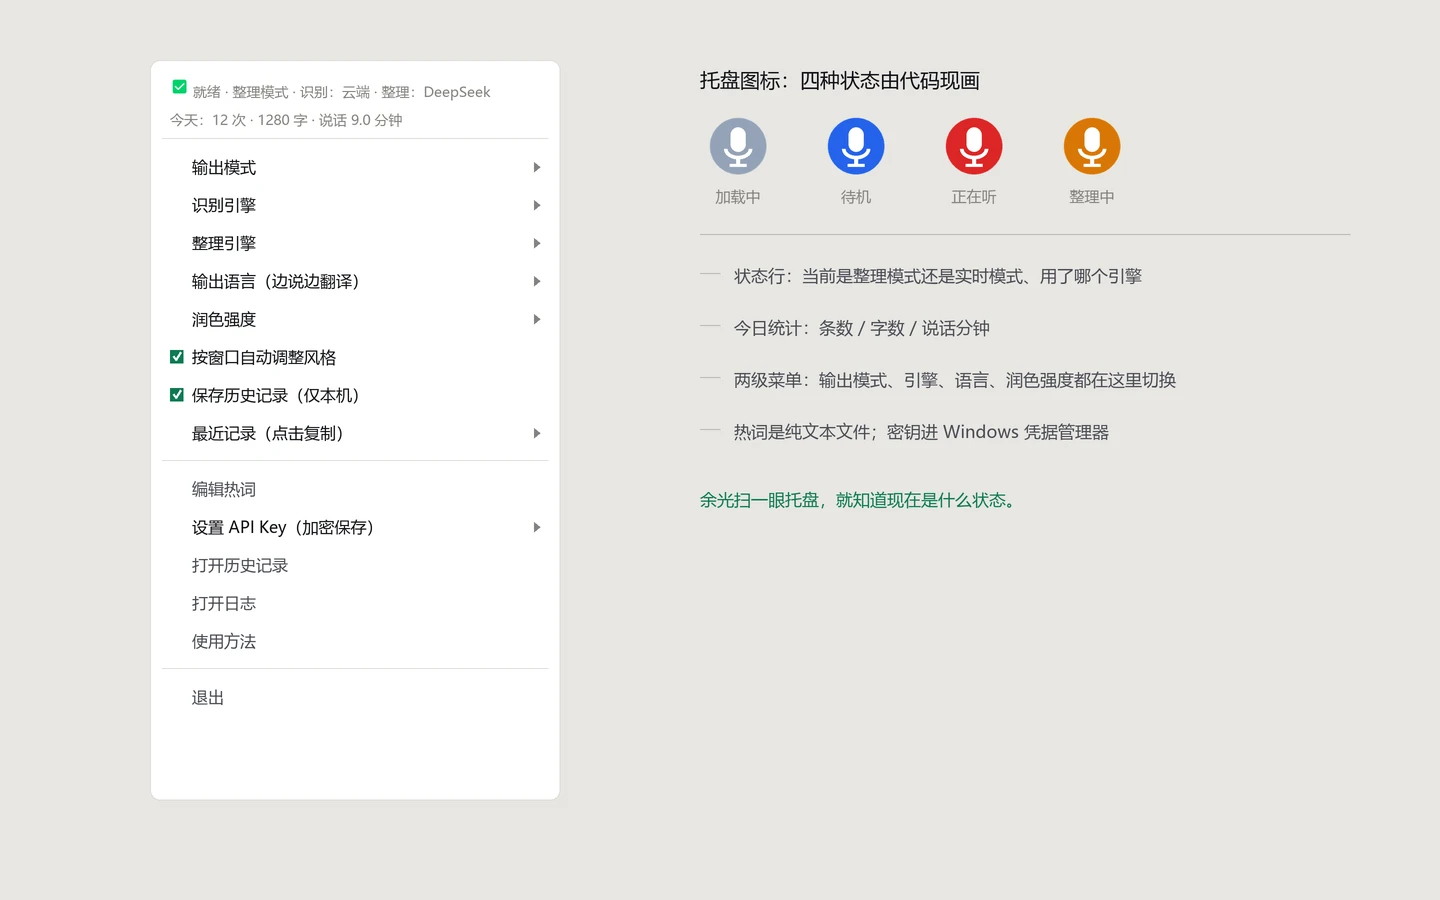
整个控制台,都在托盘里
输出模式、识别与整理引擎、输出语言、润色强度、场景自动切换、历史记录开关、编辑热词、设置密钥——不用打开任何窗口。图标按状态变色,余光扫一眼就知道它在听还是在整理。
数据
实测
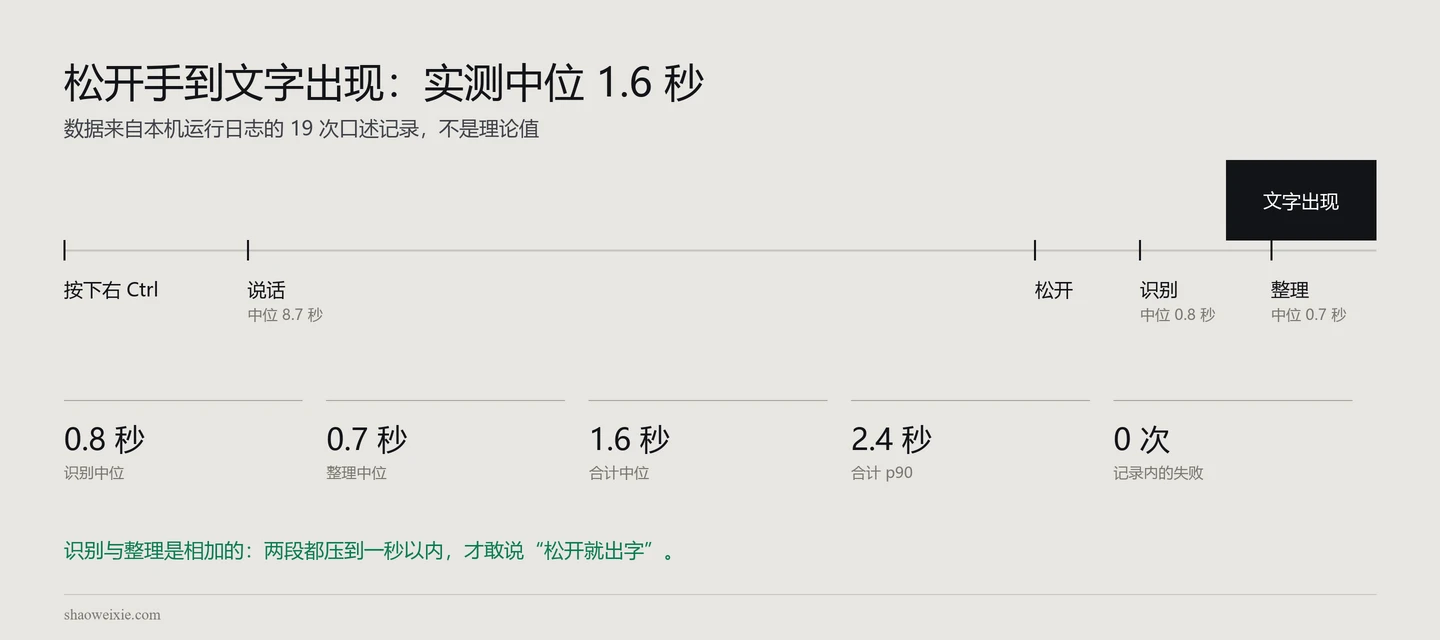
松开手到文字出现,中位 1.6 秒
这是本机运行日志里 19 次口述记录的聚合结果,不是理论值。识别与整理的时间是相加的,所以两段都压在一秒以内,才敢说「松开就出字」。
- 1.6 秒松开手到文字出现(中位)
- 19 次本机实测口述记录
- 0 次记录内的失败
- 5 类自动识别的写作场景
实现
Rust 重写
一个 2.14 MB 的单文件
核心已经用 Rust 重写:不需要 Python 运行时,双击就能跑。最容易出错的那些系统边缘——全局按键、音频采集、托盘、粘贴时序、剪贴板、凭据存储——全部换成 Rust;另外加了开机自启。
- 2.14 MBrelease 单文件(LTO + strip)
- 12个模块
- 1234行 Rust
- 0需要安装的运行时
模块划分:音频采集、实时识别、文本整理、提示词、状态机、界面、窗口与按键、密钥、配置、开机自启。已知差异:本地识别引擎尚未移植,Rust 版目前走云端实时识别。
接下来
配套硬件
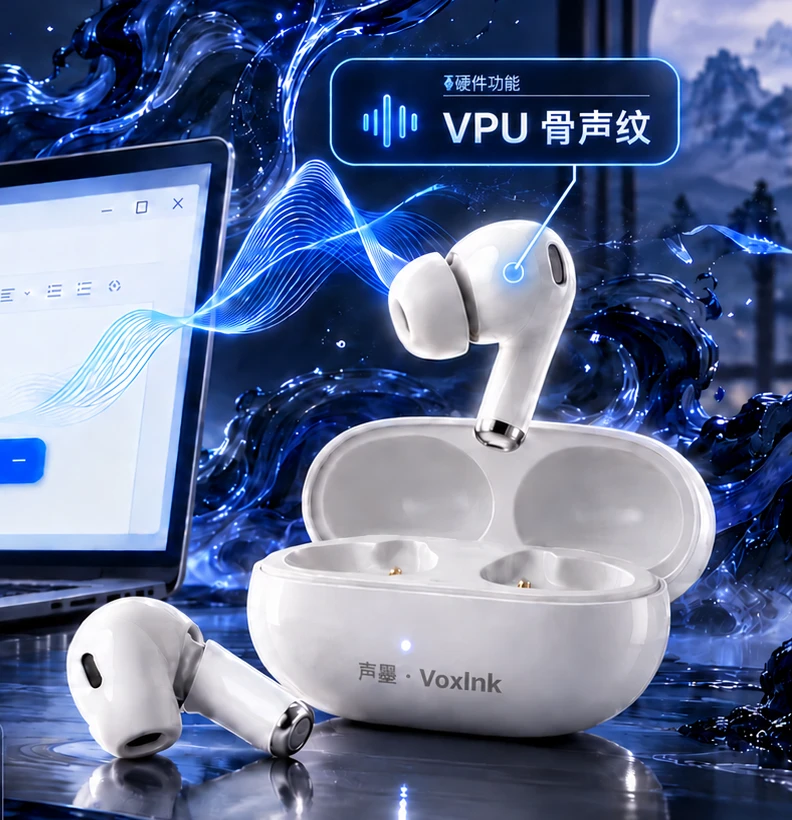
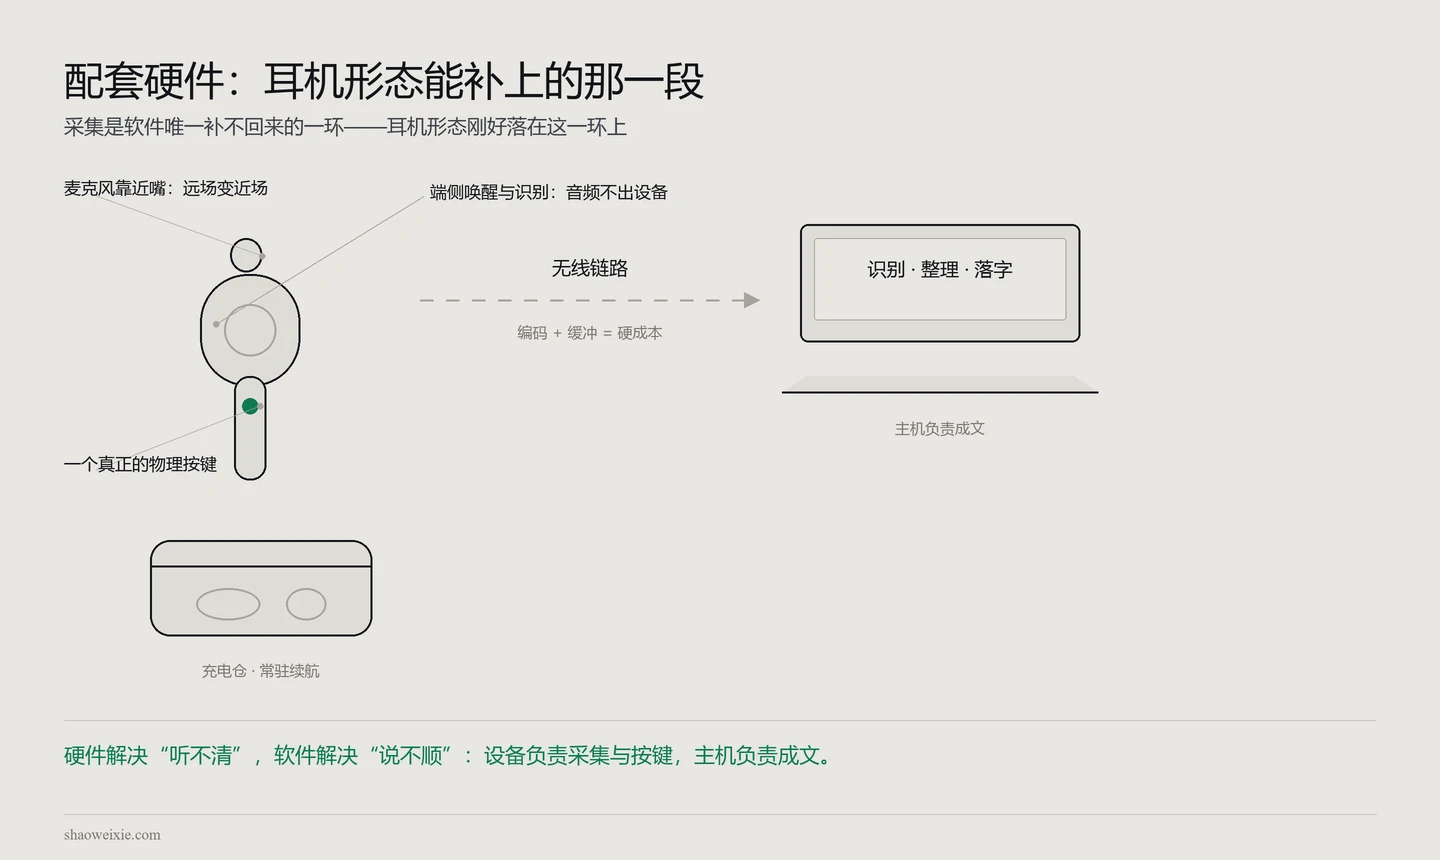
采集这一段,交给耳机形态
软件补不回在采集那一刻就丢掉的信息。耳机形态刚好落在这一段上:离嘴最近、腾得开双手、身上有地方放按键。但「整理」仍然需要主机的窗口上下文——设备负责听清,主机负责成文。
硬件方向
声纹闸门
只有你的声音,才会被写下来
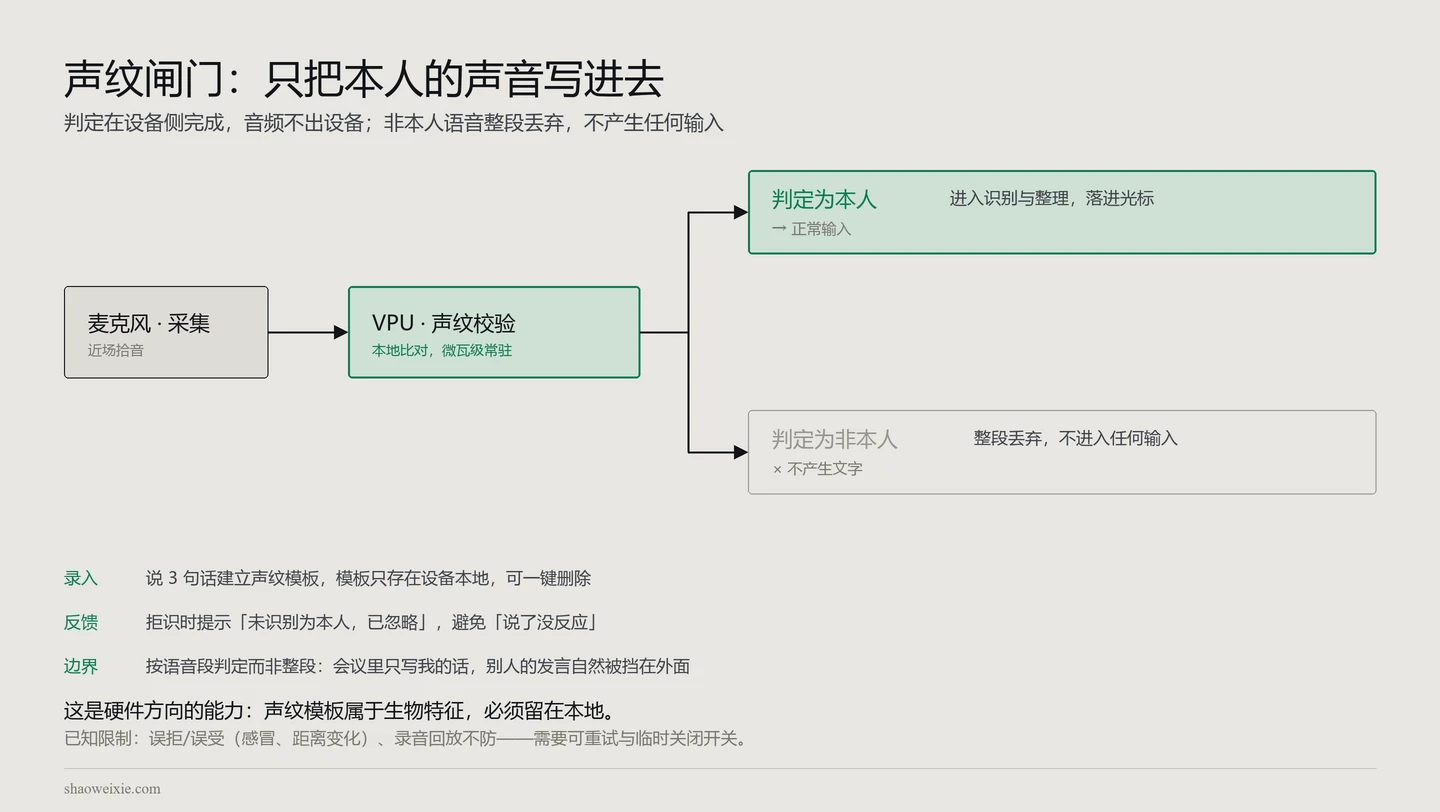
在采集之后、识别之前加一道闸门:设备上的语音处理单元(VPU)先比对声纹,判定为本人这一段才继续往下走;不是本人说的话,整段丢弃,不产生任何输入。判定在设备侧完成,音频不出设备。
- 判定位置
- 设备侧 VPU 本地比对,不需要上云,音频不离开设备
- 录入声纹
- 说 3 句话建立模板,约十秒;模板只存设备本地,可一键删除
- 闸门行为
- 本人 → 进入识别与整理,落进光标;非本人 → 整段丢弃,不产生任何文字
- 拒识反馈
- 屏幕提示「未识别为本人,已忽略」,可以立刻重说——不会出现「说了没反应」
- 判定粒度
- 按语音段判定而不是整段录音一刀切:会议里只写我说的话,别人的发言自然被挡在外面
- 已知限制
- 声纹有误拒与误受:感冒、疲劳、离麦克风的距离变化都会影响;录音回放本身不防(需要活体线索)。因此必须提供重试与临时关闭开关
- 隐私
- 声纹是生物特征:模板留在设备本地、加密存储、可删除,不参与任何云端处理
这一段是硬件方向的能力规划:当前软件版本还没有声纹链路,采集侧的硬件(麦克风 + VPU + 物理按键)先落地,才能把它接上。
Briefings
每天,把 AI 看清一点。
- 2026.10.283 个看点AI图示早报|2026年10月28日:Codex安全修复、Claude Code文件保护与LFM3
- 2026.10.273 个看点AI图示早报|2026年10月27日:Devin安全升级、Claude Code修复与Ollama候选版
- 2026.10.262 个看点AI图示早报|2026年10月26日(低新闻量版):Claude事件已解决与llama.cpp语法修复
Notes
技术、工具与随想。
写下来,才算想清楚。
- 2026.10.11嵌入式技术中科蓝讯 BT897X SDK 二次开发:先弄懂这六件事
- 2026.10.11嵌入式技术在原厂 SDK 之上立一层业务框架:结构、纪律与收益
- 2026.10.11工具与效率语音输入工具的下一步:哪里该交给硬件,哪里该换成 Rust
- 2026.10.11工具与效率语音输入的下半场:说出来的话,怎么变成能直接发出去的文字
- 2026.10.11生活随想你好,世界:网站正式上线
About
关于技术,也关于生活。欢迎交流想法、问题,或者只是打个招呼。
→ 写信给我